En juin 2025, Cisco a révélé l'existence de la vulnérabilité CVE-2025-20282, classée au niveau de gravité maximal, dans son Identity Services Engine. La cause première était l'absence de contrôle de validation des fichiers au moment du téléchargement, ce qui pouvait permettre à un attaquant non authentifié de placer un fichier spécialement conçu dans un répertoire privilégié et de l'exécuter en tant qu'administrateur. La faille se situait en amont du processus de détection, c'est-à-dire au niveau de ce que le système acceptait avant même que le moteur d'analyse ne soit lancé.
Ce schéma n'est pas propre à un seul produit. Le nombre de moteurs dans une pile constitue rarement une contrainte. Un fichier doit être analysé avant de pouvoir être évalué, et les formats modernes imbriquent le contenu d'une manière qui n'est pas toujours accessible à l'analyse.
Pourquoi le résultat du scanner était normal ?
L'analyse basée sur les signatures fonctionne par comparaison d'octets. Un moteur dispose d'une base de données contenant des hachages et des séquences d'octets issus de logiciels malveillants connus, et un fichier doit présenter des octets correspondants pour être détecté. Plusieurs facteurs empêchent cela de se produire avec du contenu imbriqué.
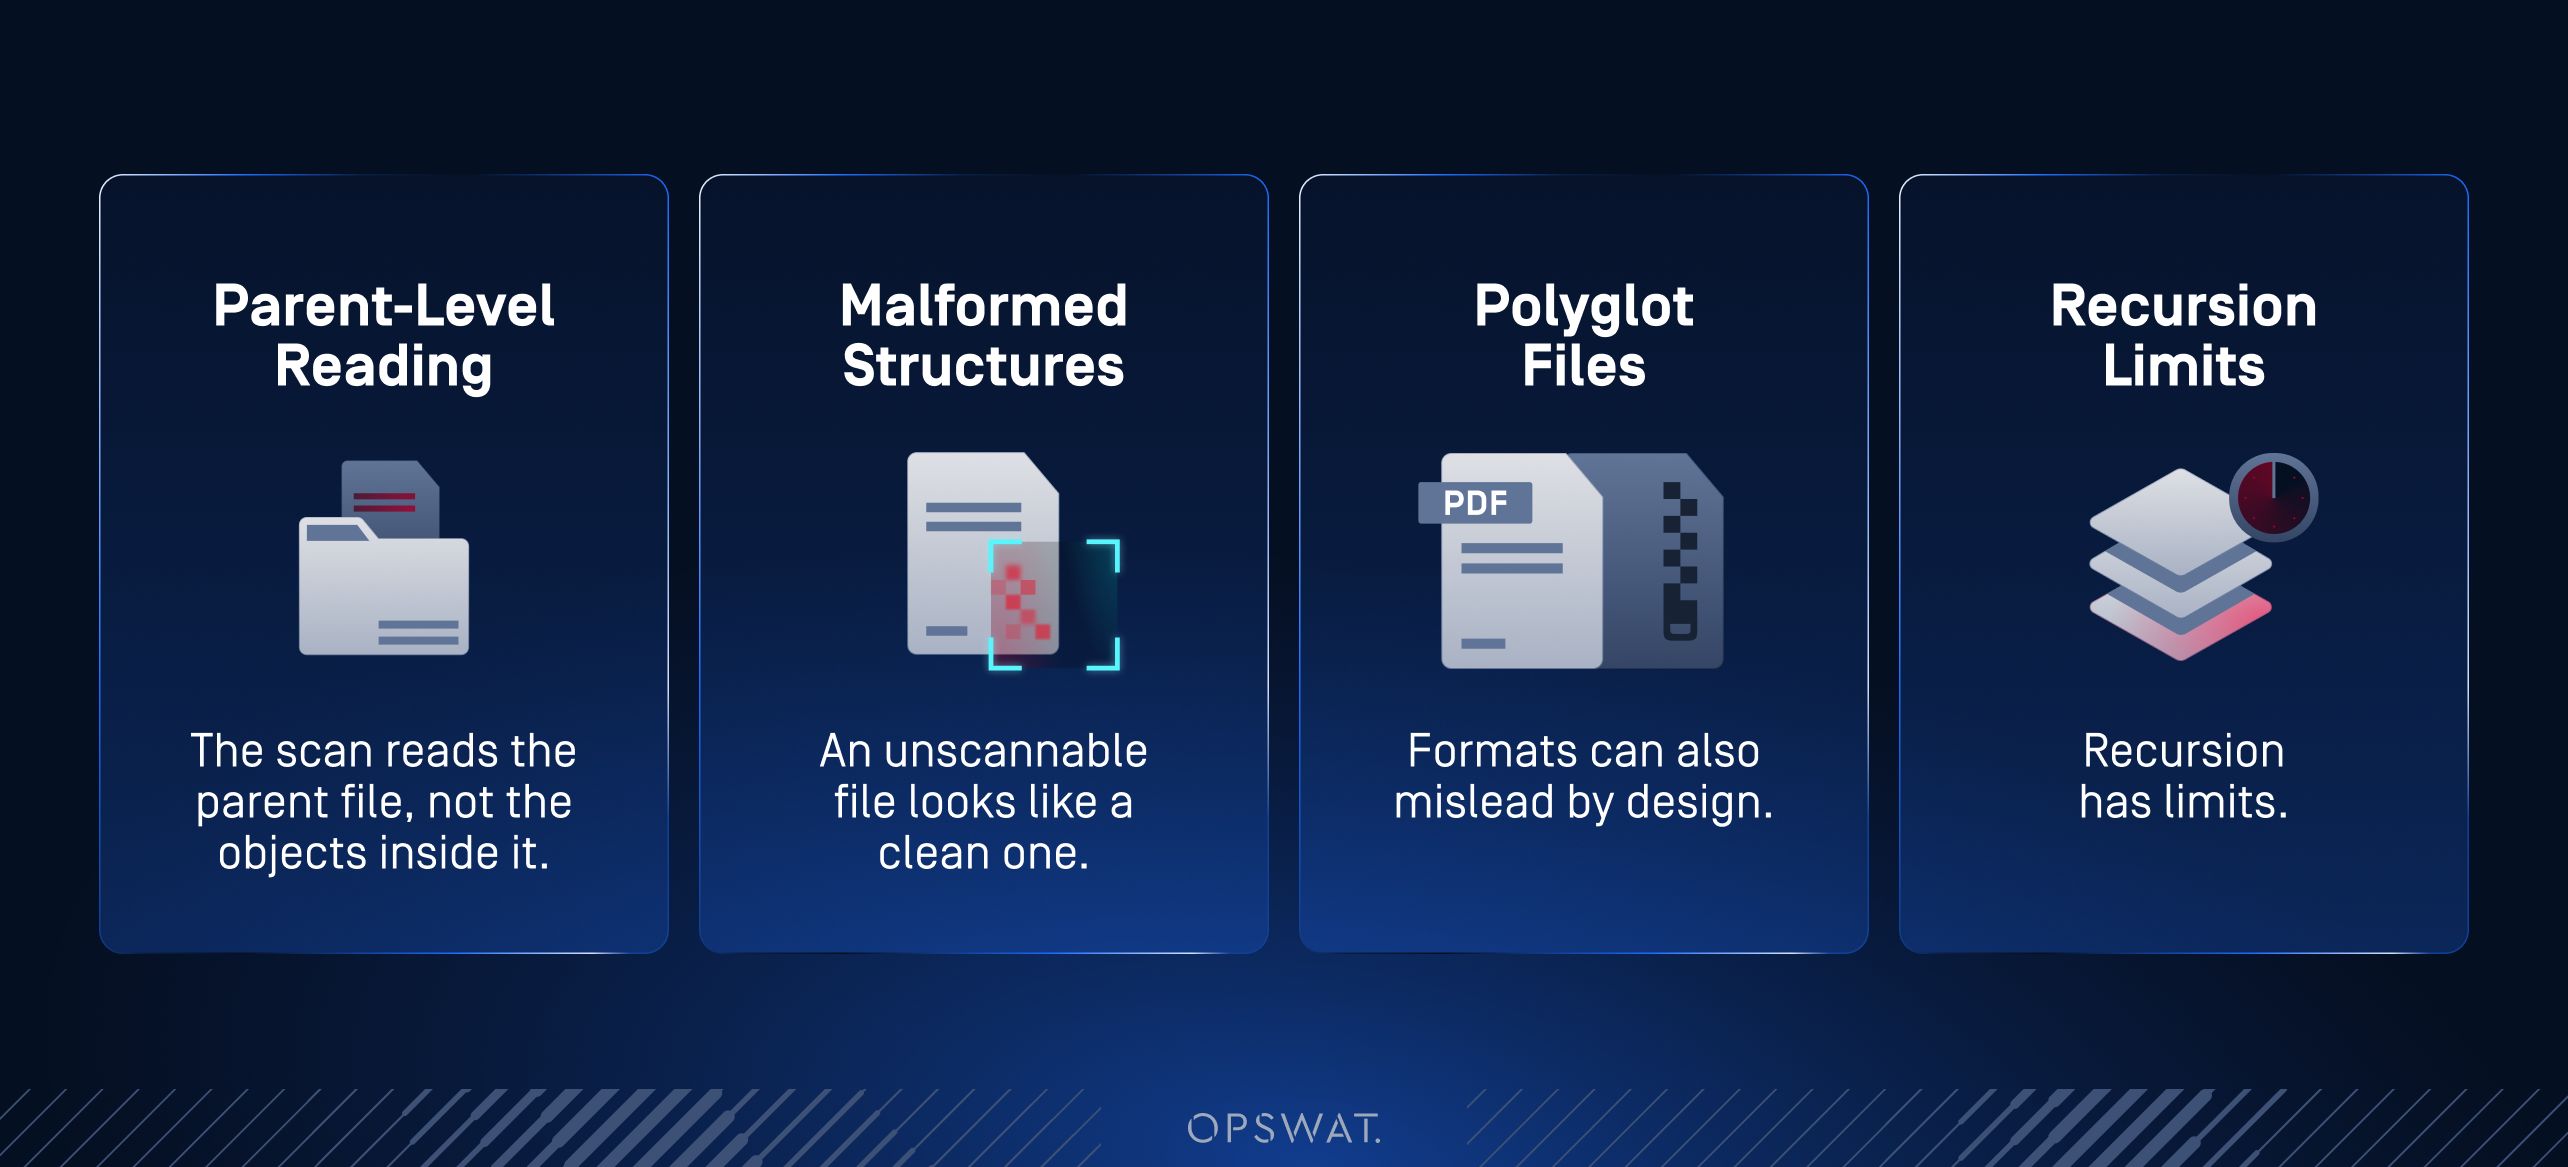
- L'analyse porte sur le fichier parent, et non sur les objets qu'il contient. Lors d'une analyse, le fichier considéré est traité comme un objet binaire unique et comparé à la base de données de signatures. Le contenu imbriqué est stocké sous forme compressée ou codée ; ainsi, un exécutable situé au sein d'un flux de données ne partage pratiquement aucune séquence d'octets avec le même exécutable présent sur le disque. Le motif recherché par la base de données est absent du fichier tel qu'il est stocké, et il ne devient comparable qu'une fois ce flux décompressé.
- Un fichier non analysable ressemble à un fichier sain. Une structure mal formée empêche l'analyse. Le moteur ne peut pas mener à bien son évaluation ; le fichier est donc ignoré plutôt que bloqué, et un résultat signifiant « n'a pas pu être évalué » est transmis en aval, sans qu'il soit possible de le distinguer d'un résultat signifiant « rien trouvé ».
- Les formats peuvent également induire en erreur de par leur conception. Un fichier polyglotte répond à deux spécifications de format à la fois ; ainsi, un analyseur le reconnaît comme tel, alors que le fichier se comporte en réalité de manière totalement différente.
- La récursivité a ses limites. Les conteneurs imbriqués sont soumis à des limites de profondeur et à des délais d'expiration de balayage, et ce à juste titre, car une récursivité illimitée constitue en soi un risque de déni de service. Une charge utile placée en dessous de cette limite n'est jamais évaluée, et il est bien plus facile de la placer à un niveau trop profond pour que le moteur puisse l'atteindre que de contourner cette limitation.
Il en résulte un verdict moins révélateur qu'il n'y paraît. Un résultat « propre » signifie qu'aucun modèle connu n'a été identifié dans la partie du fichier que le moteur a pu analyser. Cela ne fournit aucune indication sur les composants contenus dans le fichier, ni sur les couches que le moteur n'a jamais ouvertes.
Chaque couche a un rôle à jouer. Il en manquait une.
L'analyse basée sur les signatures n'est jamais utilisée seule. Les architectures modernes de sécurité des fichiers sont souvent conçues selon une approche en couches, et les couches qui l'entourent ont pour but de pallier les lacunes de la reconnaissance de motifs.
L'identification du type de fichier permet de déterminer le type réel d'un fichier à partir de son en-tête plutôt que de son extension déclarée. De par sa conception, cette méthode est rapide et superficielle ; elle est conçue pour déterminer où un fichier doit être classé plutôt que pour analyser son contenu. L'analyse dynamique observe le comportement d'un fichier dans un environnement contrôlé. C'est l'outil idéal pour faire face aux menaces inconnues, et elle est particulièrement efficace lorsqu'elle est appliquée de manière sélective plutôt qu'à l'ensemble des fichiers.
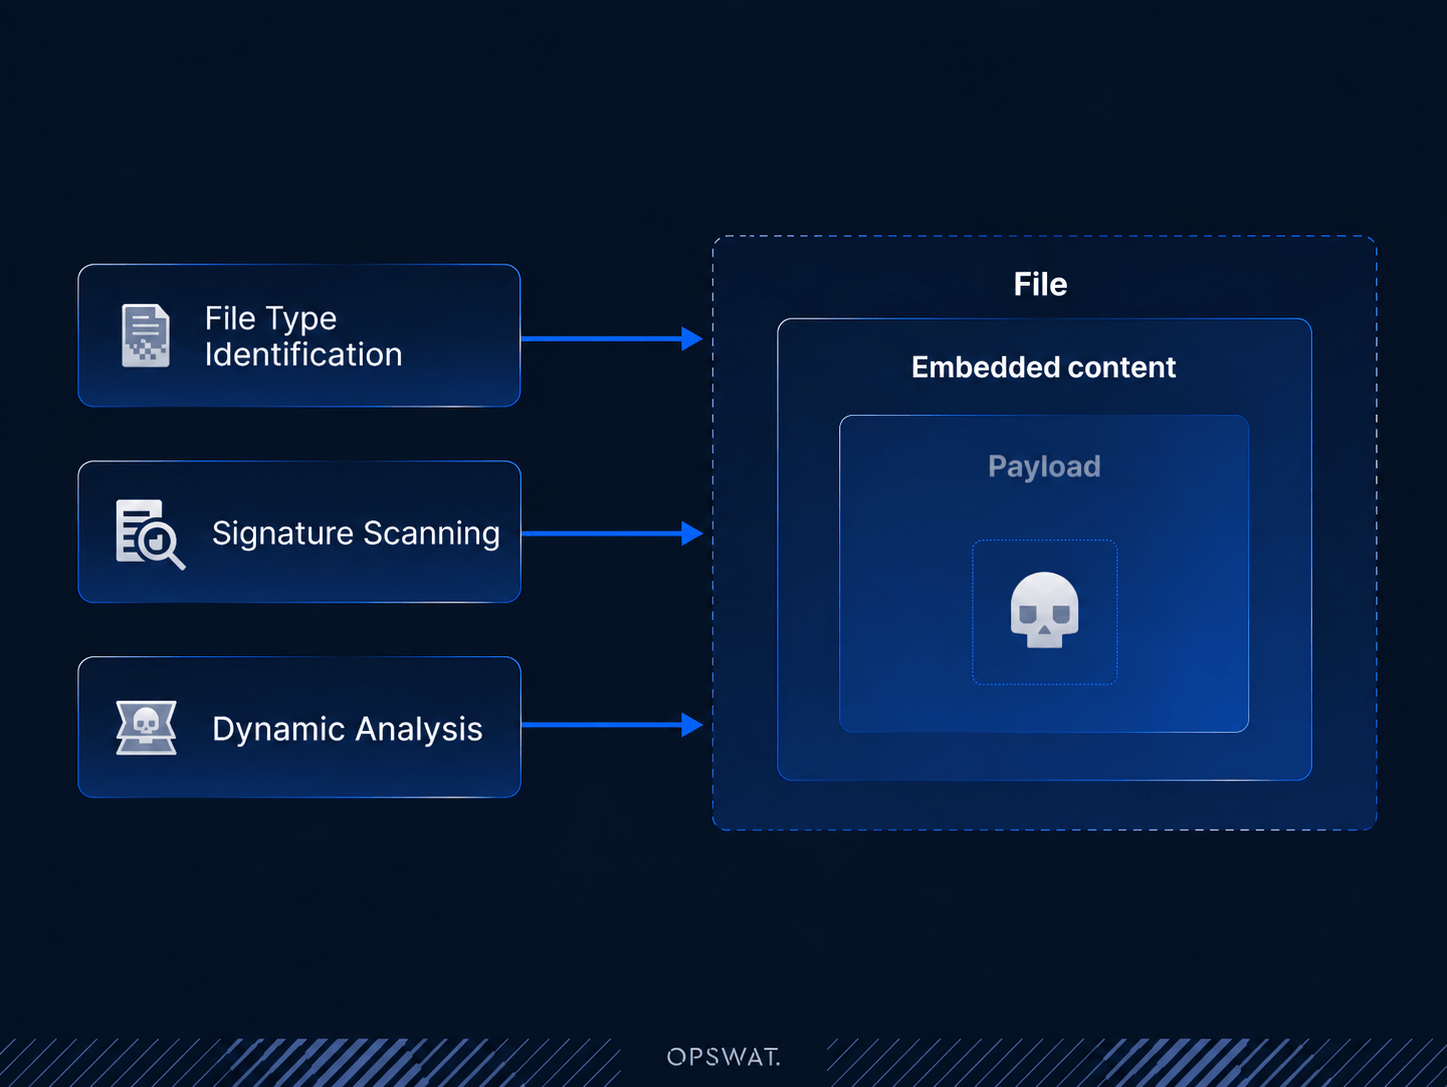
Chaque couche remplit son rôle, mais lorsqu’une charge utile n’est jamais dissociée du fichier qui la transporte, ou se situe en dessous d’une limite de profondeur, ce contenu n’atteint jamais aucune de ces couches ; l’ajout de couches supplémentaires ne sert donc à rien pour compenser. L’angle mort s’étend le plus loin dans les formats qui ne disposent d’aucun chemin de validation : fichiers de base de données, données SIG, fichiers de modèles d’IA. Ces formats ne peuvent pas être reconstruits ; la couche qui serait normalement chargée de détecter une menace inconnue est donc, par définition, indisponible.
Il manque une couche dont la seule fonction est d’établir au préalable la « vérité de référence » structurelle : analyser un fichier par rapport à sa spécification de format, en extraire tous les composants intégrés et rendre ces composants accessibles individuellement à toutes les étapes en aval. C’est précisément le problème que la validation de la structure des fichiers a été conçue pour résoudre.
Comment la validation de la structure des fichiers comble cette lacune
La validation de la structure des fichiers s'exécute avant que le reste de la pile ne soit activé. Elle vérifie la conformité d'un fichier à sa spécification de format parmi plus de 160 types de fichiers, notamment les formats SIG, de bases de données et de modèles d'IA, le décompose en ses différents composants et applique une politique à chacun d'entre eux.
Les objets sont acheminés vers le moteur le plus à même de les analyser : Metascan™ Multiscanning, Adaptive Sandbox , la technologie Proactive DLP™, ou OPSWAT Alin AI. Le fichier d'origine est ensuite transmis à la technologie Deep CDR™ pour être nettoyé, le cas échéant.
Ce qui importe ici, c’est l’impact sur l’analyse. La comparaison de signatures reste le moyen le plus rapide et le plus économique d’identifier les logiciels malveillants connus, et la validation de la structure des fichiers ne remplace en rien ce processus. Elle modifie simplement ce qui est transmis aux moteurs. La charge utile arrive sous la forme d’un fichier autonome, déjà décompressé et déjà classé ; le moteur effectue donc la comparaison sur l’objet lui-même plutôt que sur un fragment compressé enfoui à l’intérieur d’un fichier parent. Les moteurs de détection reçoivent exactement les octets que leurs bases de données ont été conçues pour reconnaître, et c’est là qu’ils font ce qu’ils ont toujours su faire : détecter les menaces.
Voir dans un fichier
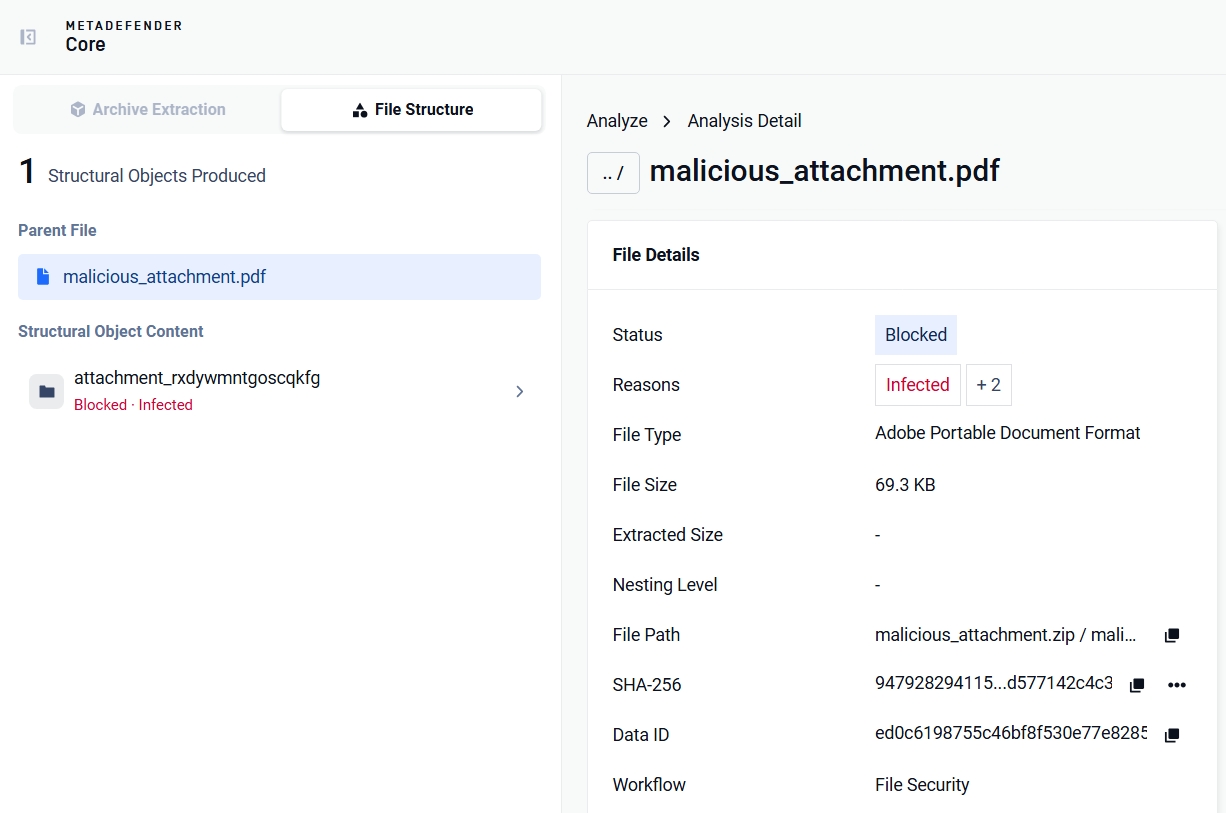
La meilleure façon d'illustrer cela est de présenter un fichier qui passe les analyses sans être détecté, mais qui contient néanmoins une charge utile malveillante. Nous avons créé une démonstration de principe dans laquelle une charge utile malveillante est dissimulée à l'intérieur d'un fichier PDF inoffensif. Cet échantillon a ensuite été soumis à une série de moteurs anti-malware, qui ont tous donné un résultat « propre ».
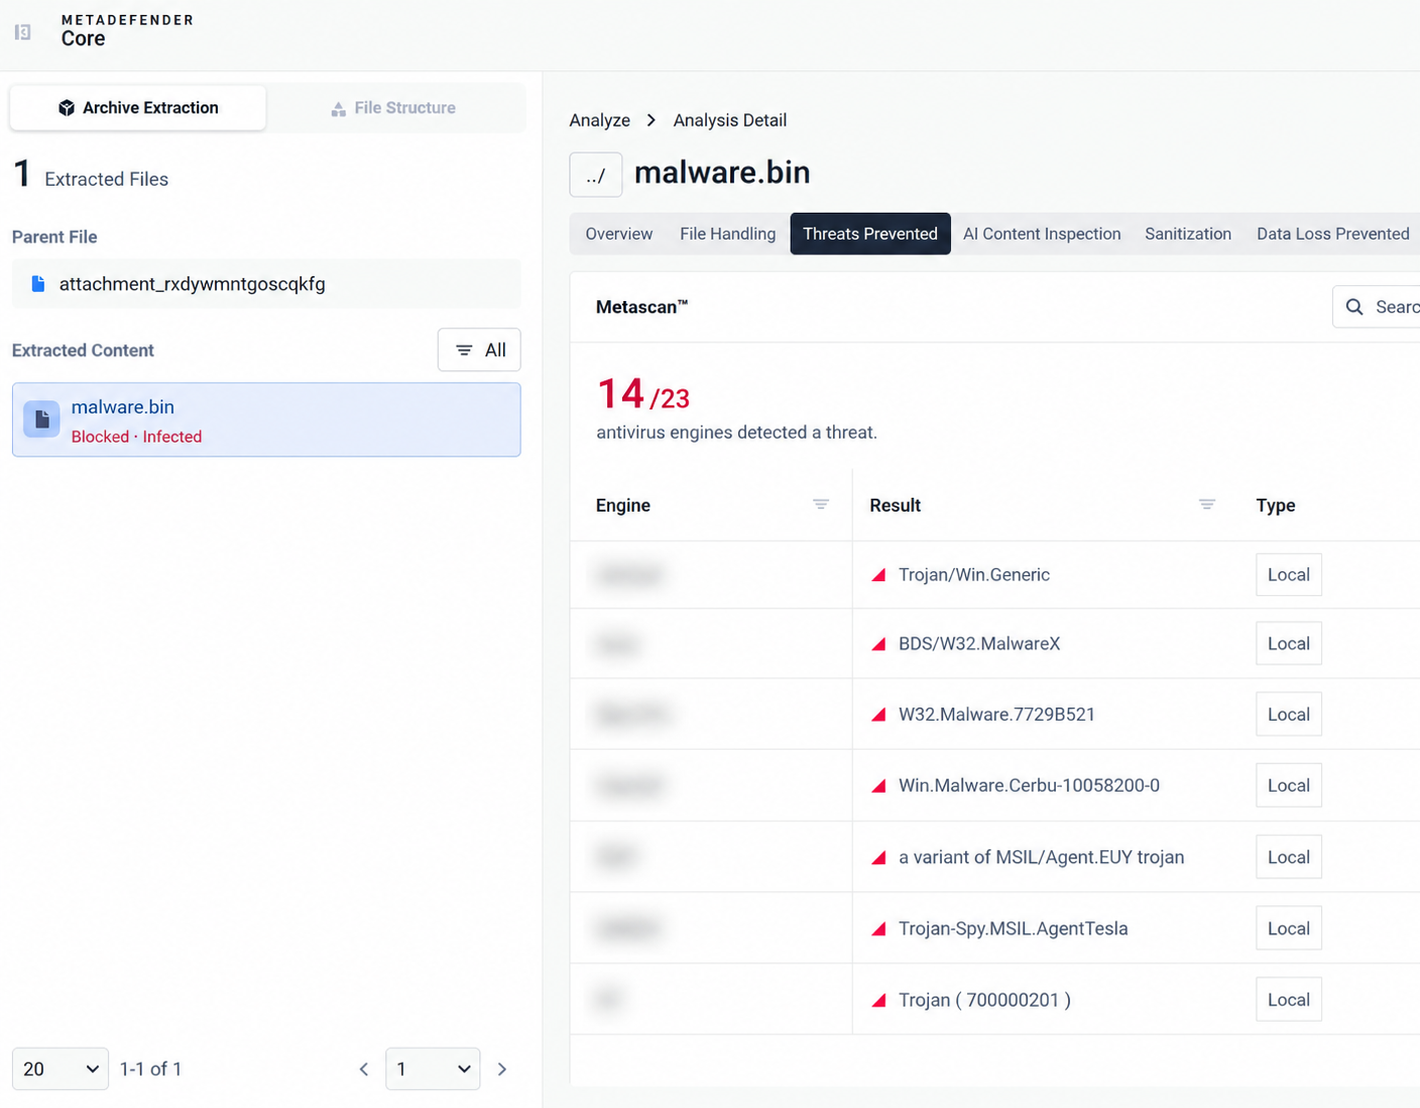
L'étape suivante consiste à analyser ce fichier dans MetaDefender Core™ avec la validation de la structure des fichiers activée. Après avoir extrait les composants imbriqués du fichier parent, la validation de la structure des fichiers envoie les objets générés aux moteurs en aval pour une analyse plus approfondie.
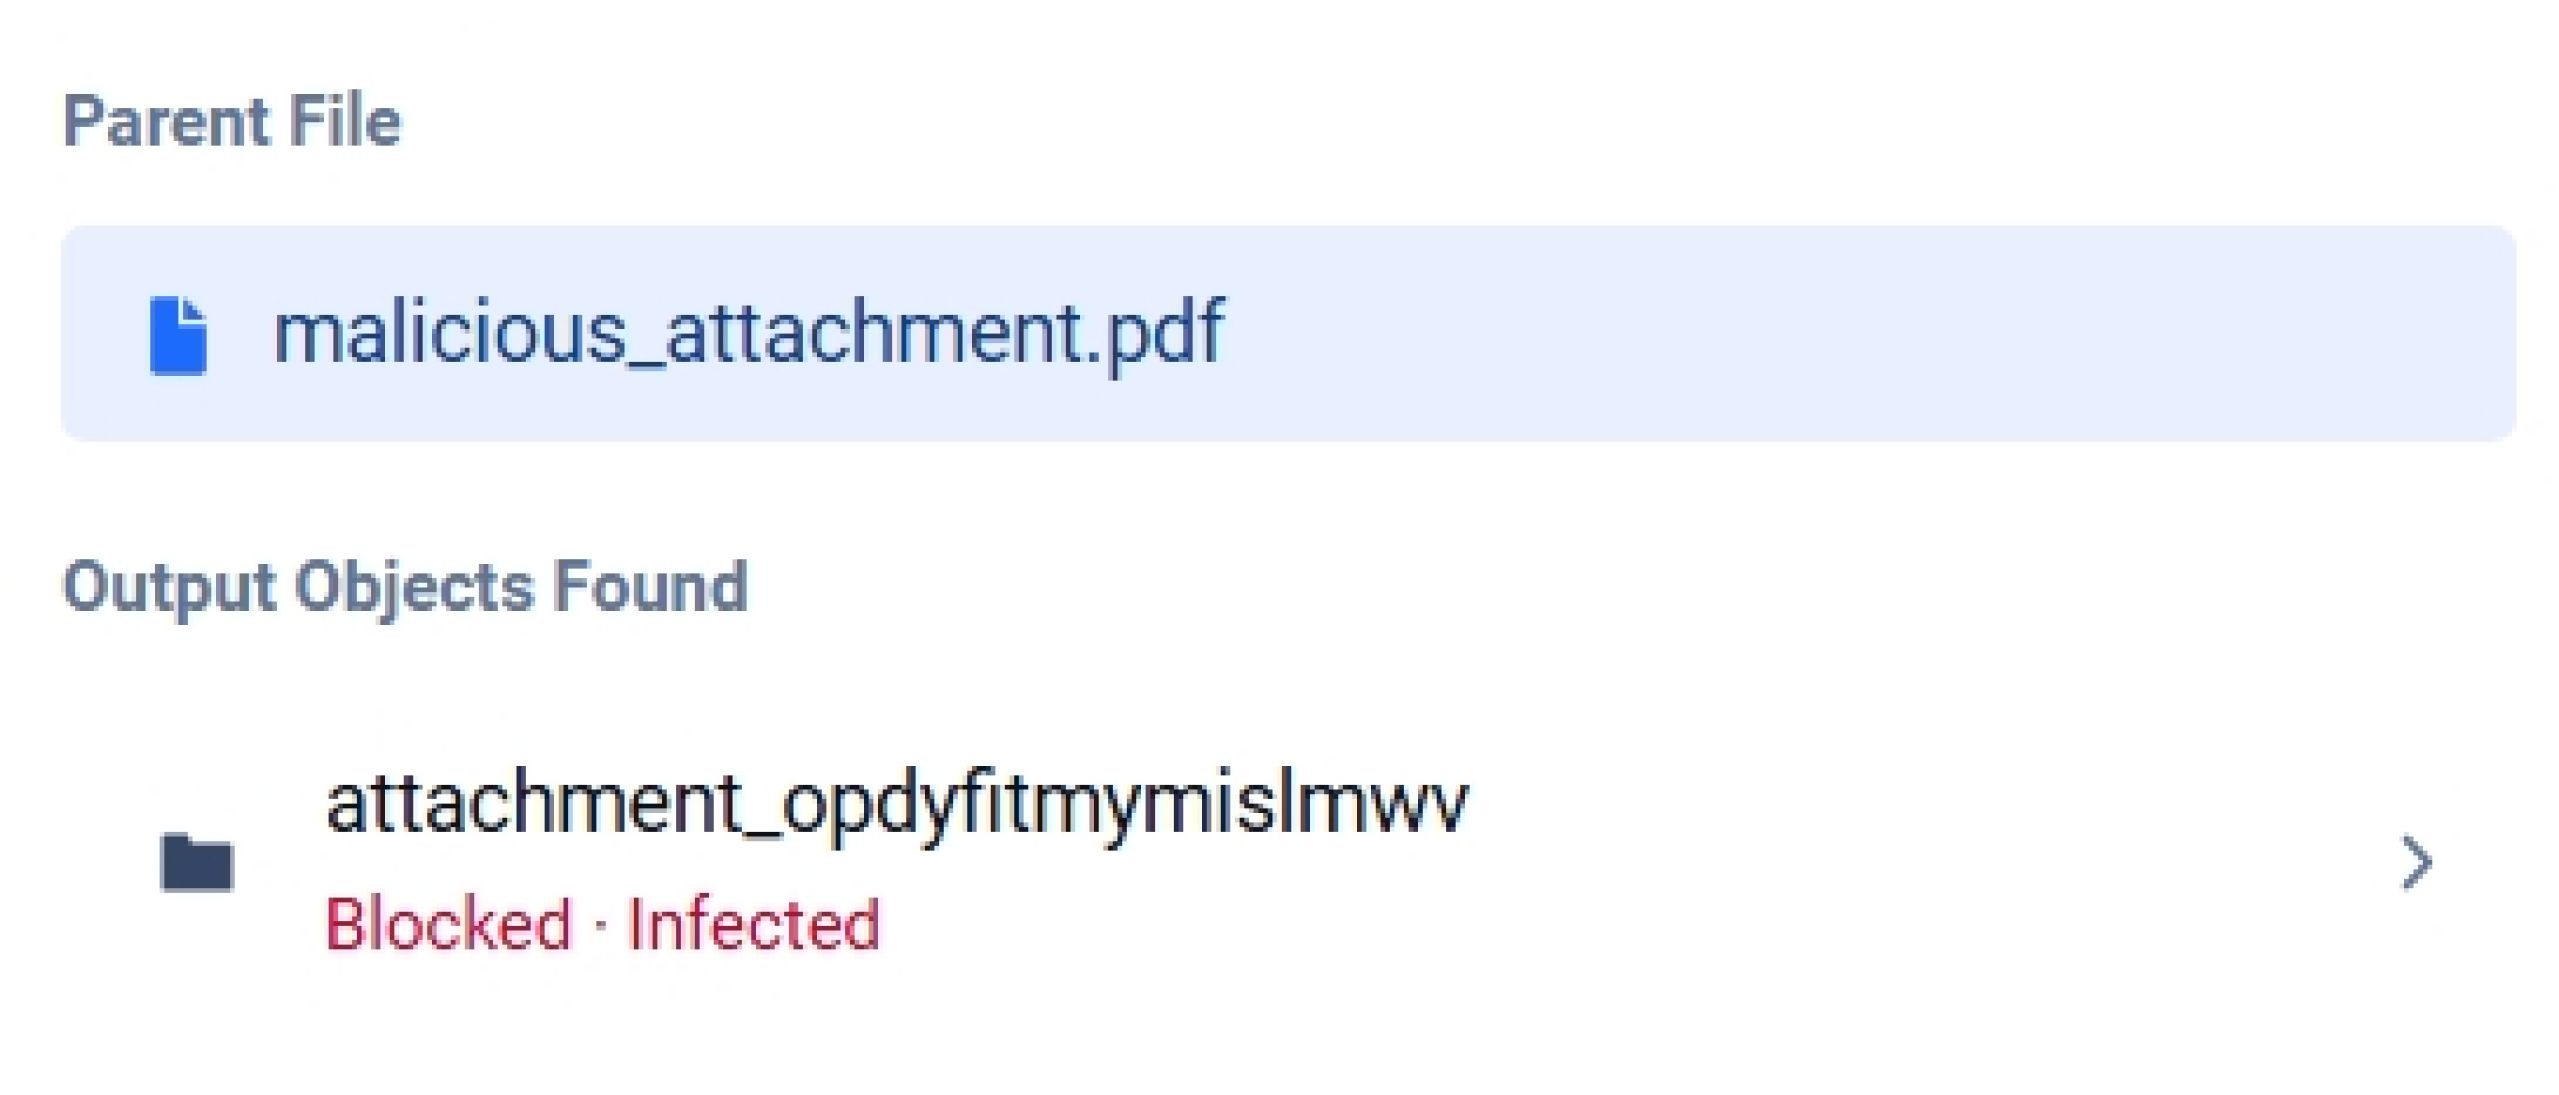
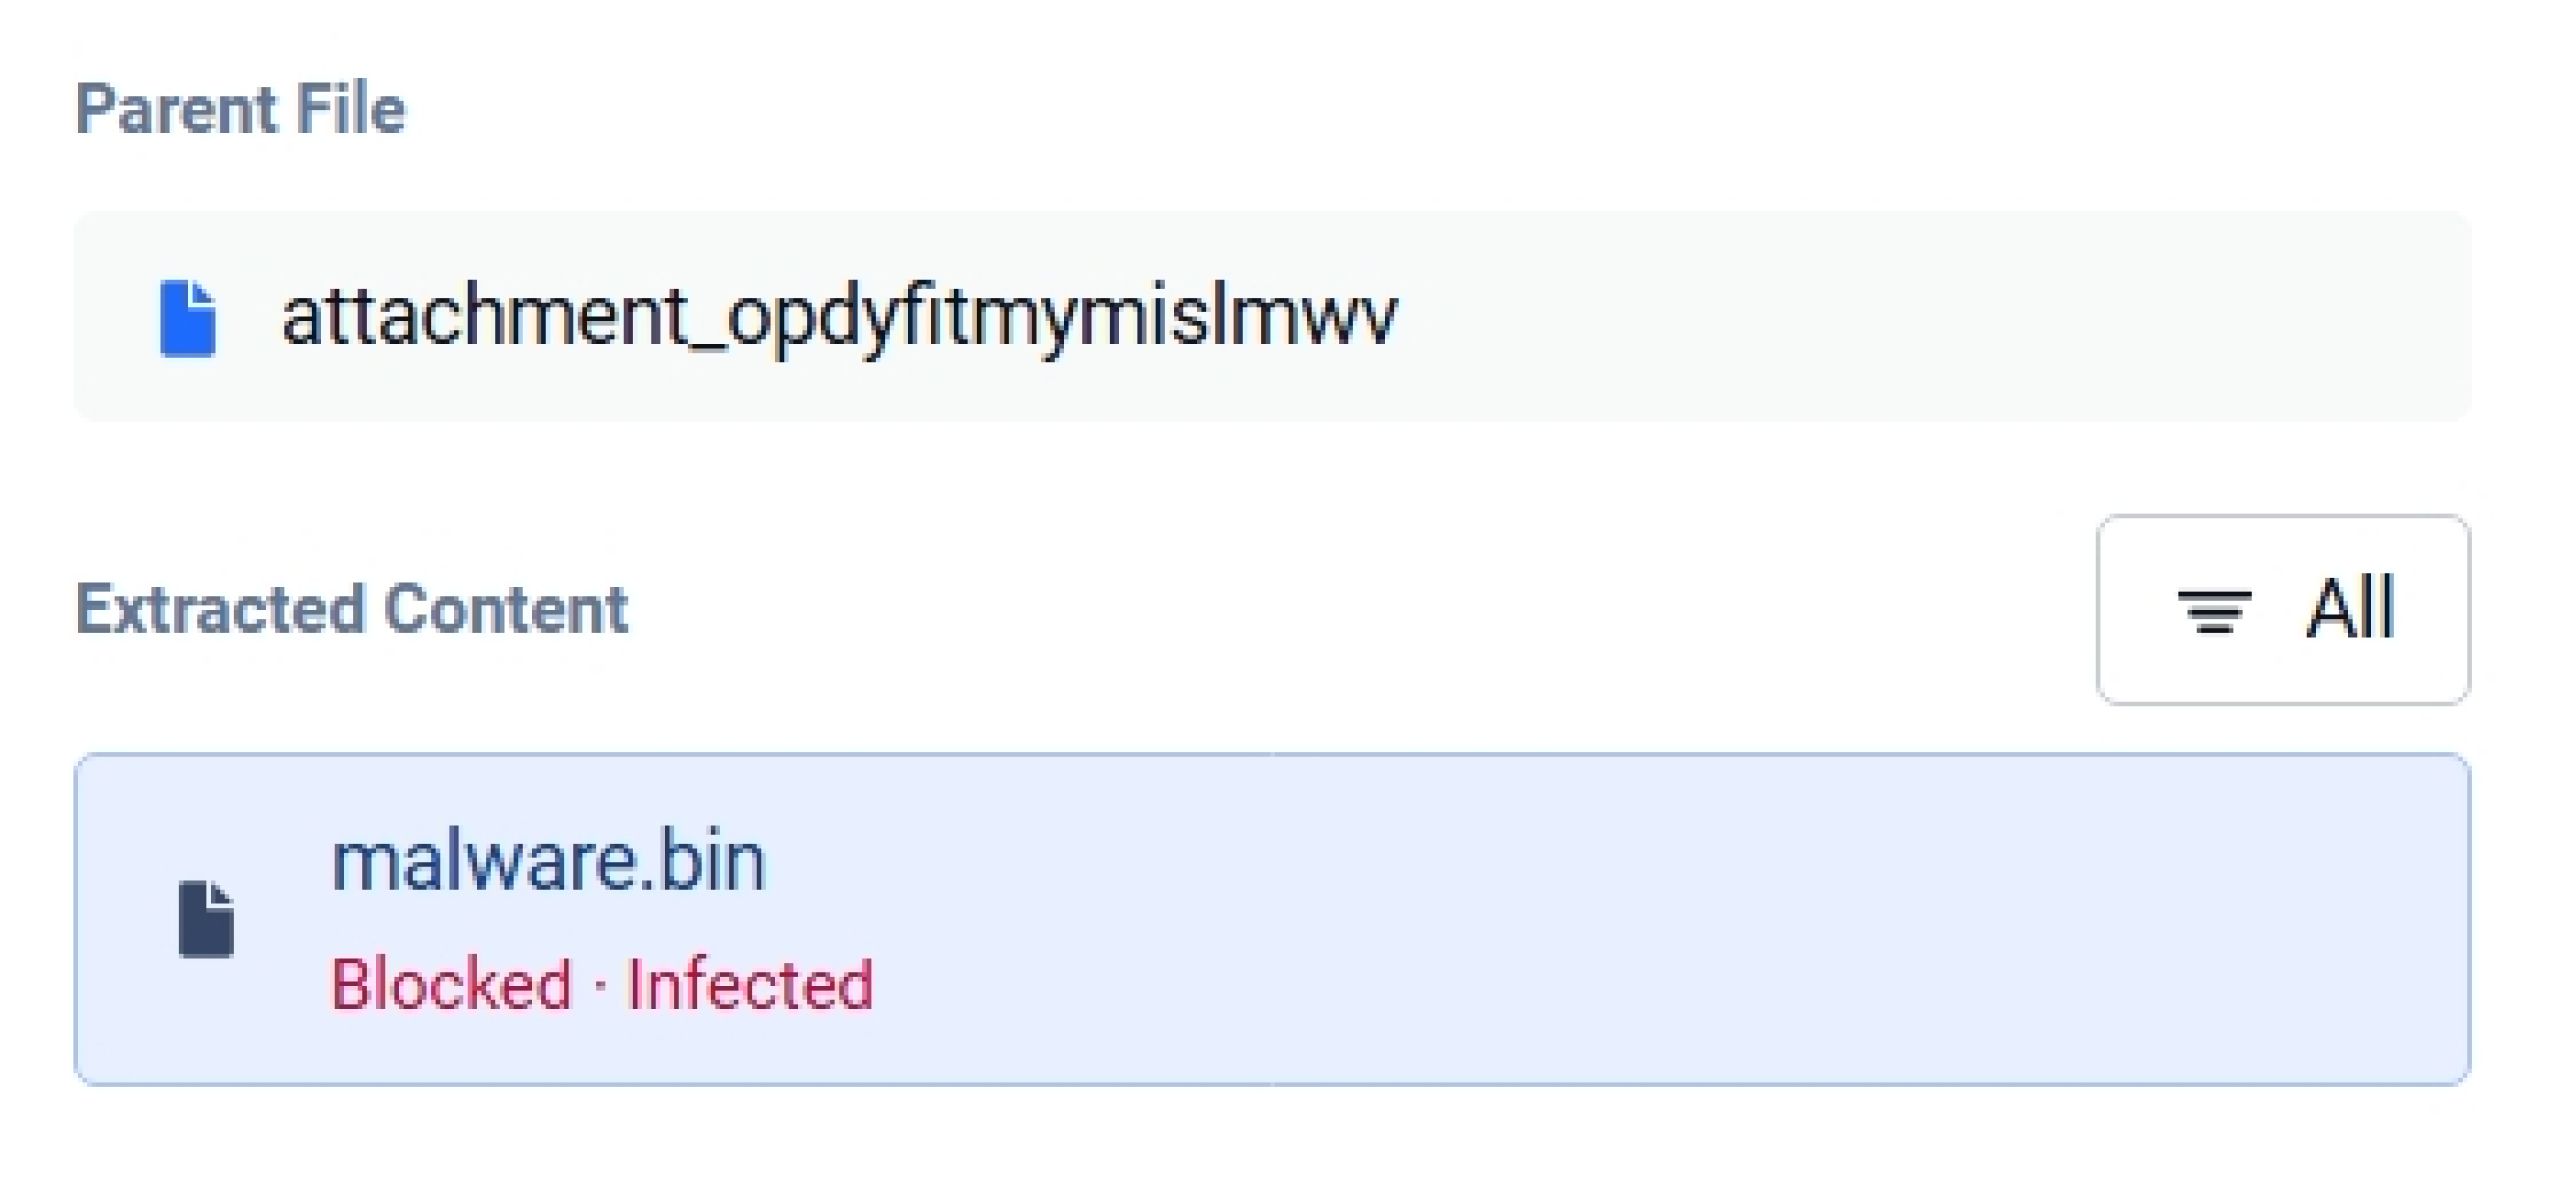
Les moteurs anti-malware Metascan™ Multiscanning ont rendu un verdict « infecté ». Les mêmes bases de signatures qui n’avaient détecté aucune menace ont signalé une infection dès lors que la charge utile a été présentée comme un fichier à part entière.
Par où commencer ?
Une analyse « propre » indique ce qu'un moteur est capable d'analyser. La question de savoir si le fichier contient un élément dangereux est distincte, et y répondre relève d'un problème structurel qui doit être résolu avant même que le premier moteur de détection ne soit lancé.
Que cela implique une validation de la structure des fichiers seule ou associée à un nettoyage et à une analyse dynamique dépend de vos types de fichiers, de vos flux de travail et de vos exigences en matière d'intégrité. N'hésitez pas à nous contacter pour déterminer quelle combinaison convient le mieux à votre environnement.