Le fichier qui satisfait à tous les critères de contrôle
Les pipelines de sécurité des fichiers reposent sur un principe rarement remis en question : un fichier n'a qu'un seul type. Le détecteur l'identifie et la politique l'achemine. Chaque moteur en aval analyse ensuite le fichier en fonction de ce type: anti-malware, sandbox et nettoyage.
Les fichiers « polyglottes » contredisent cette hypothèse. Un flux d'octets unique peut être à la fois un fichier GIF parfaitement valide et une archive Java parfaitement valide. La même astuce fonctionne avec un fichier JPEG qui est également une archive RAR, ou un PDF contenant un fichier ZIP complet au-delà de sa fin logique. Chaque partie est conforme aux normes en soi, de sorte qu’aucun analyseur de format individuel ne détecte d’anomalie.
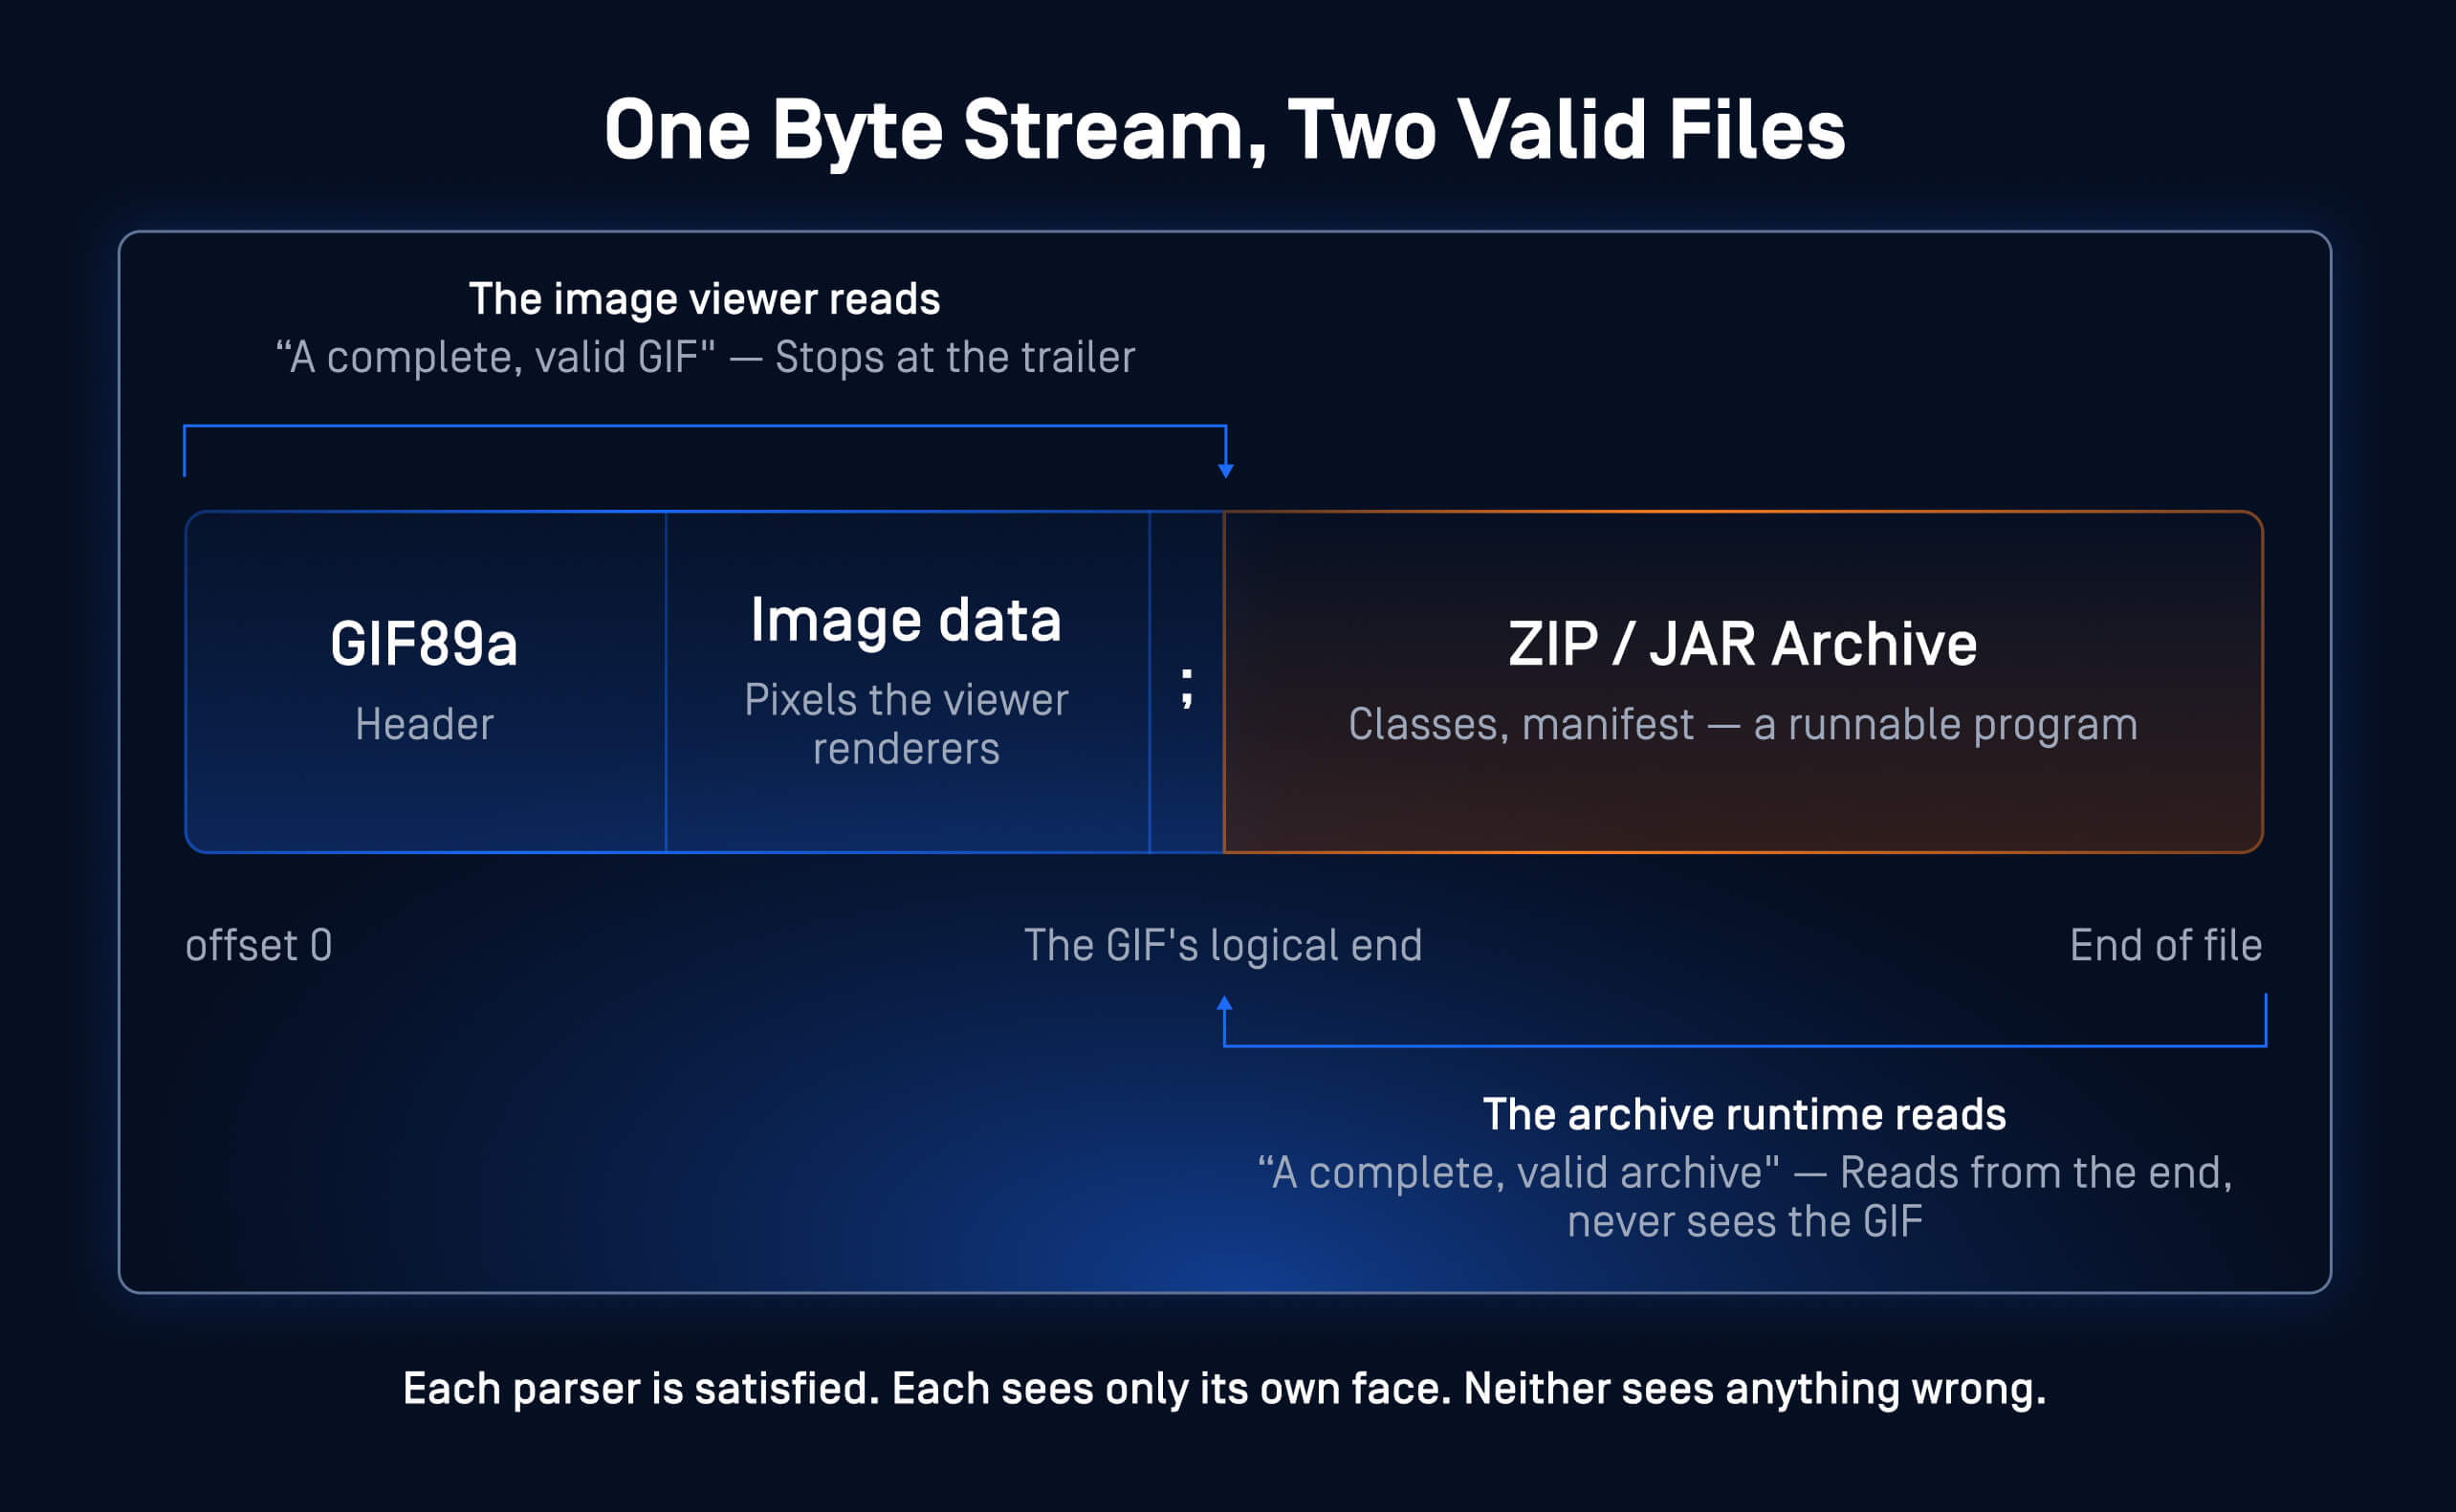
Un multilingue en une seule image : le classique GIF+JAR. Deux analyseurs syntaxiques, deux points d'entrée, un seul fichier, et chaque visage est parfaitement valide.
La conséquence en matière de sécurité est claire : le pipeline analyse le fichier en fonction du type qu’il a détecté, tandis que l’autre format passe inaperçu. Une image qui est également un script devient une attaque XSS stockée lorsqu’une application web la renvoie. Une archive dissimulée derrière une image permet à sa charge utile de contourner les filtres de contenu. Les chaînes d’attaque reposant sur ce principe, de la combinaison classique GIF+JAR à la diffusion d’exploits assistée par la stéganographie, sont connues du grand public depuis près de deux décennies. Les moteurs anti-malware restent largement aveugles face à ces menaces, car chaque élément, inspecté séparément, est inoffensif.
Comment le moteur trouve un deuxième visage
Notre moteur de validation de la structure des fichiers intègre une détection polyglotte sous la forme d'une étape de prétraitement appliquée à chaque fichier analysé, avant tout traitement de format. Sa conception repose sur trois principes.
- Analyse complète du flux. Le scanner compare l'intégralité du fichier à une liste de signatures « magic » de formats. Tout nouveau format détecté n'importe où dans le flux est signalé avec son décalage exact, même si le type du fichier a déjà été identifié. Cela inclut les signatures ajoutées après le marqueur de fin de fichier d'un PDF ou dissimulées derrière les données de pixels d'une image.
- Savoir où un format prend légitimement fin. Les formats Container peuvent légalement contenir d’autres fichiers. Une image à l’intérieur d’un fichier ZIP est considérée comme du contenu ordinaire. Le détecteur détermine la véritable fin de chaque conteneur à partir de la structure propre à ce dernier. La fin d’un PDF, le répertoire central d’un fichier ZIP et l’allocation de secteurs d’un fichier composite OLE (Object Linking and Embedding) marquent chacun cette limite. L’analyse des PDF tient compte des mises à jour incrémentielles. Seules les signatures situées en dehors de cette structure sont considérées comme une seconde face. C’est cette limite structurelle qui distingue un véritable verdict polyglotte d’une fausse alerte sur toute archive ordinaire.
- Vérifiez avant d'accuser. Le moteur extrait chaque élément candidat du flux et le réidentifie de manière indépendante à l'aide de notre moteur « File Type » avant de le signaler. Les éléments candidats identifiés comme des données non structurées sont écartés. Un verdict signifie qu'un deuxième format est réellement analysé à cet offset. Des octets magiques isolés ne suffisent jamais à eux seuls à en générer un.
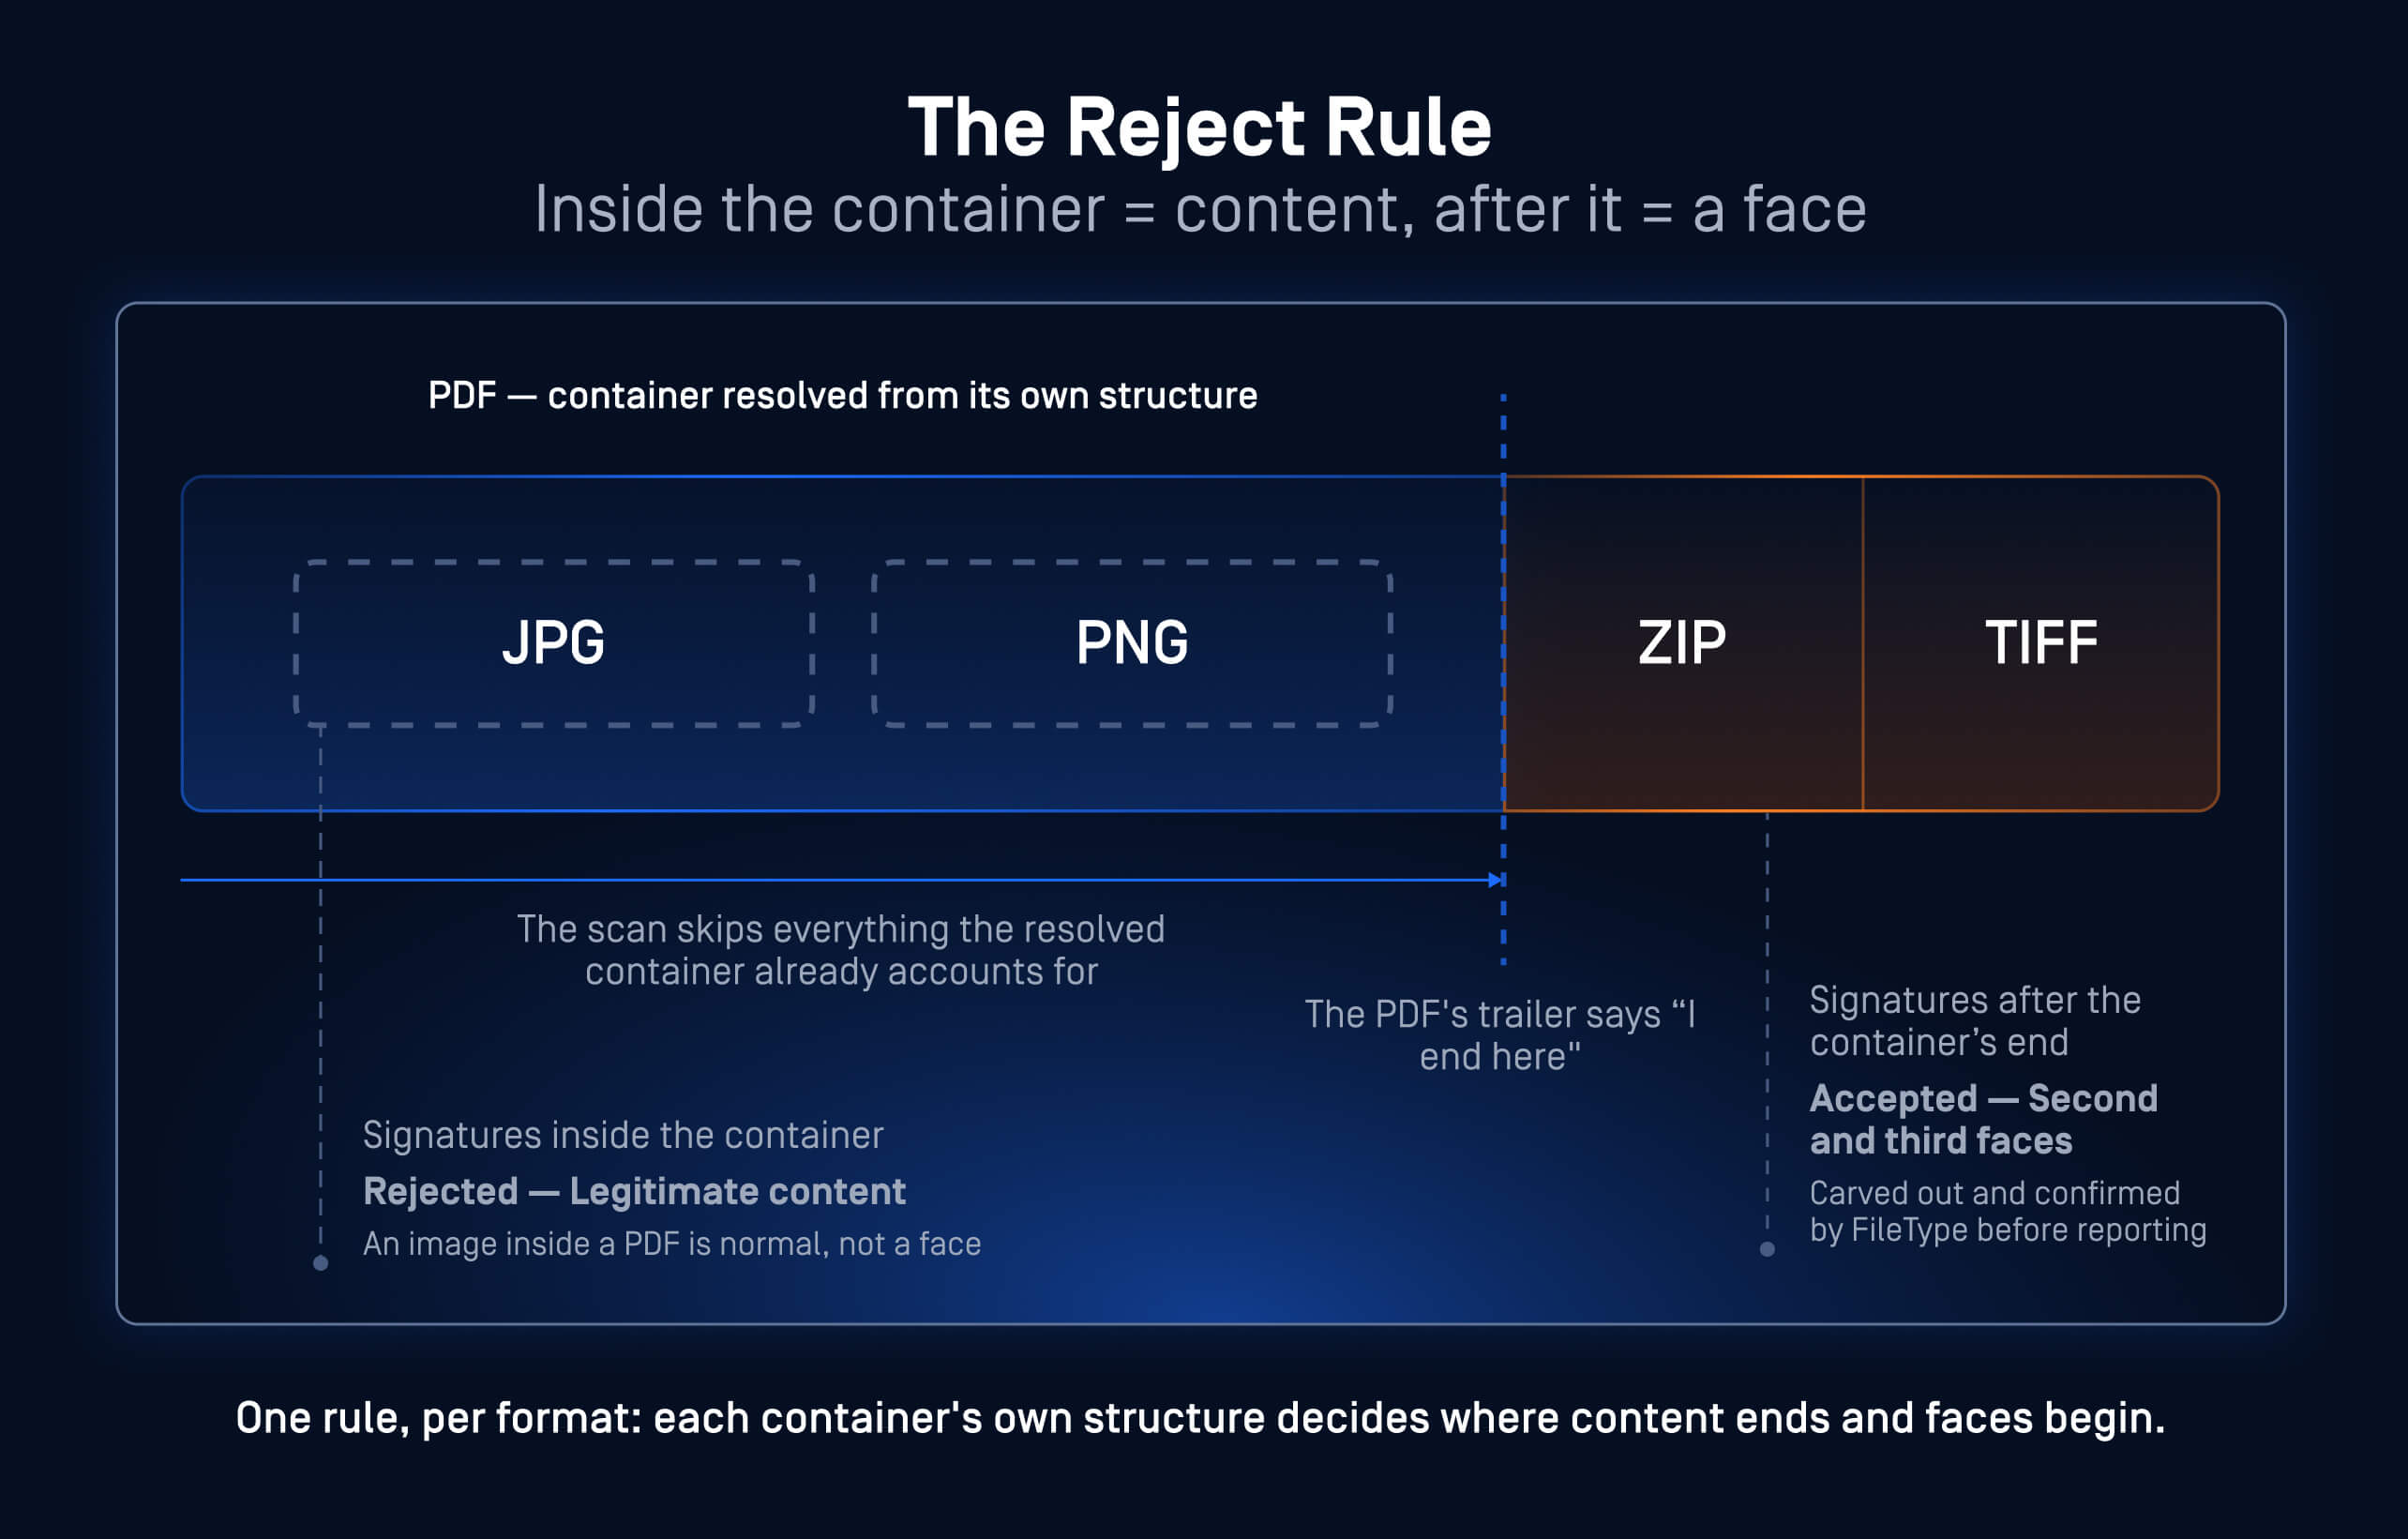
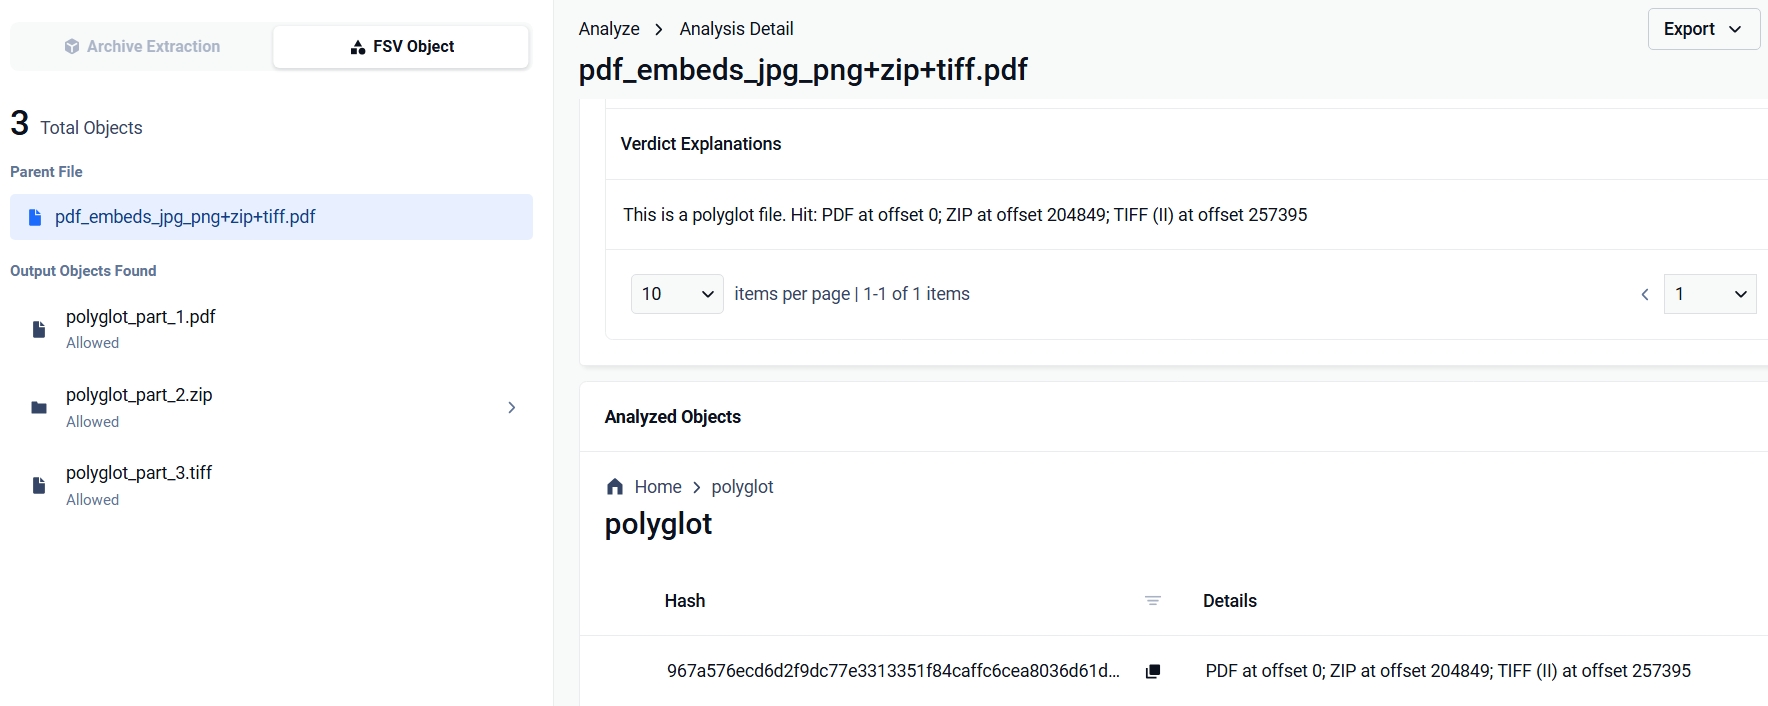
Extrait d'un échantillon réel : un fichier PDF intégrant un fichier JPG et un fichier PNG, avec un fichier ZIP et un fichier TIFF ajoutés à la fin de sa structure logique. Le verdict mentionne le fichier ZIP et le fichier TIFF, mais ne fait aucune mention des images intégrées.
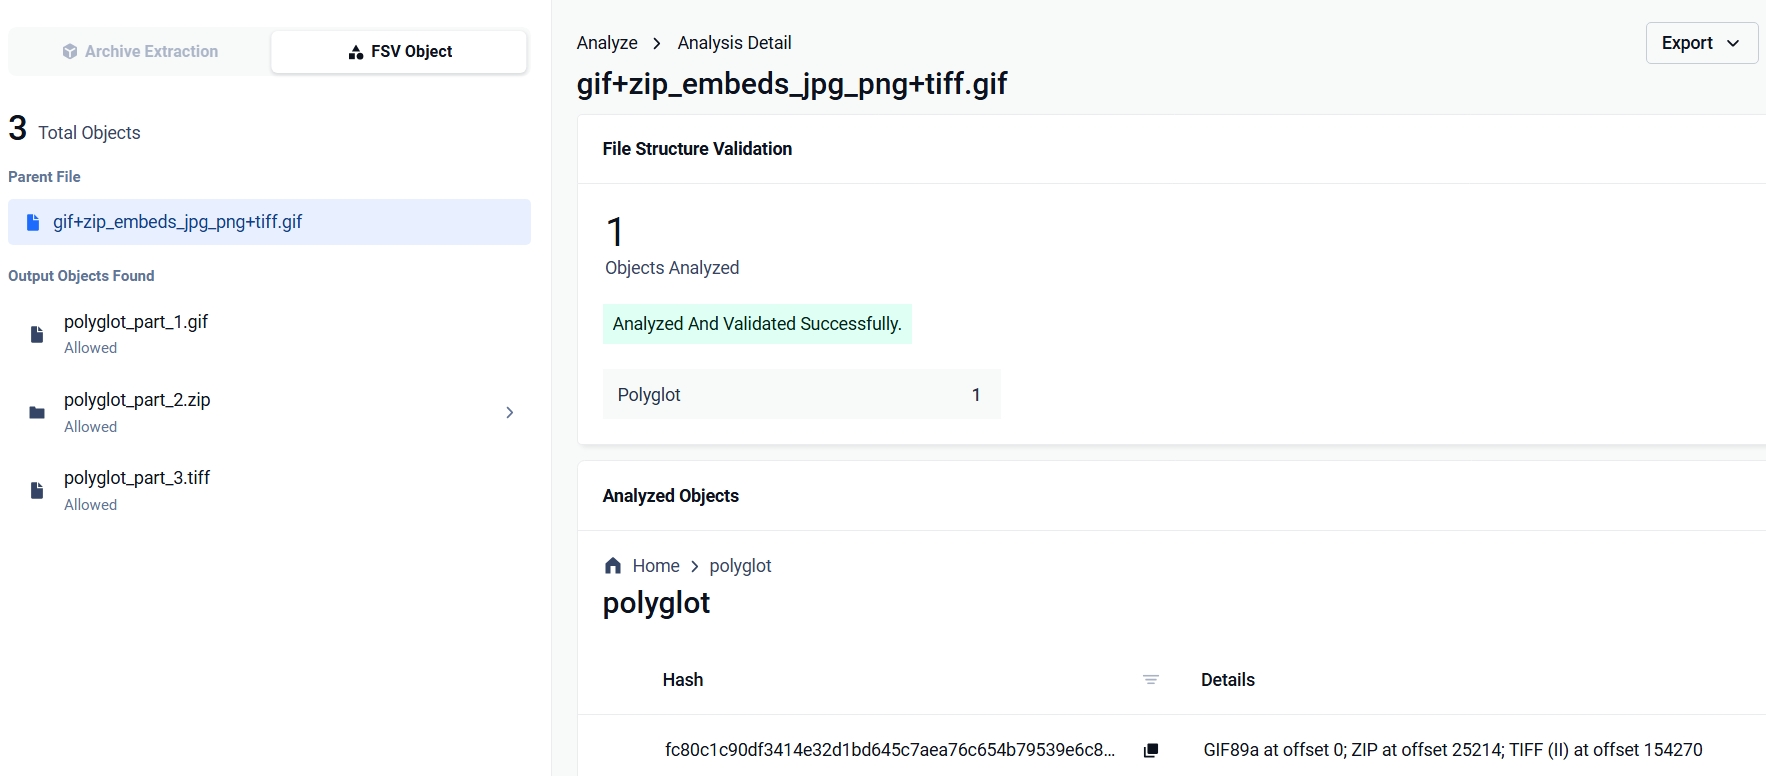
Le résultat répertorie chaque face avec son offset. Un fichier .gif mis en ligne, par exemple, est identifié comme un GIF89a à l'offset 0 et comme une archive ZIP plus loin dans le flux. La politique définit la suite : signaler la découverte ou bloquer purement et simplement le fichier en fournissant une explication détaillant les résultats positifs.
De la détection à la dissection
La détection ne constitue que la moitié de la solution, car toute la ruse du « polyglotte » réside dans le fait que chaque élément en apparence inoffensif. Une fois la détection effectuée, le moteur dissèque le fichier. Chaque élément confirmé est exporté sous forme d’objet distinct (polyglot_part_1.pdf, polyglot_part_2.zip, etc.) avec son format, son décalage et sa taille. Le moteur renvoie ensuite chacun d’entre eux au flux de travail d’MetaDefender Core™ pour un traitement complet en fonction de leur nature réelle.
Nous avons vérifié cela de bout en bout sur une instance Core™ d'MetaDefender en production.
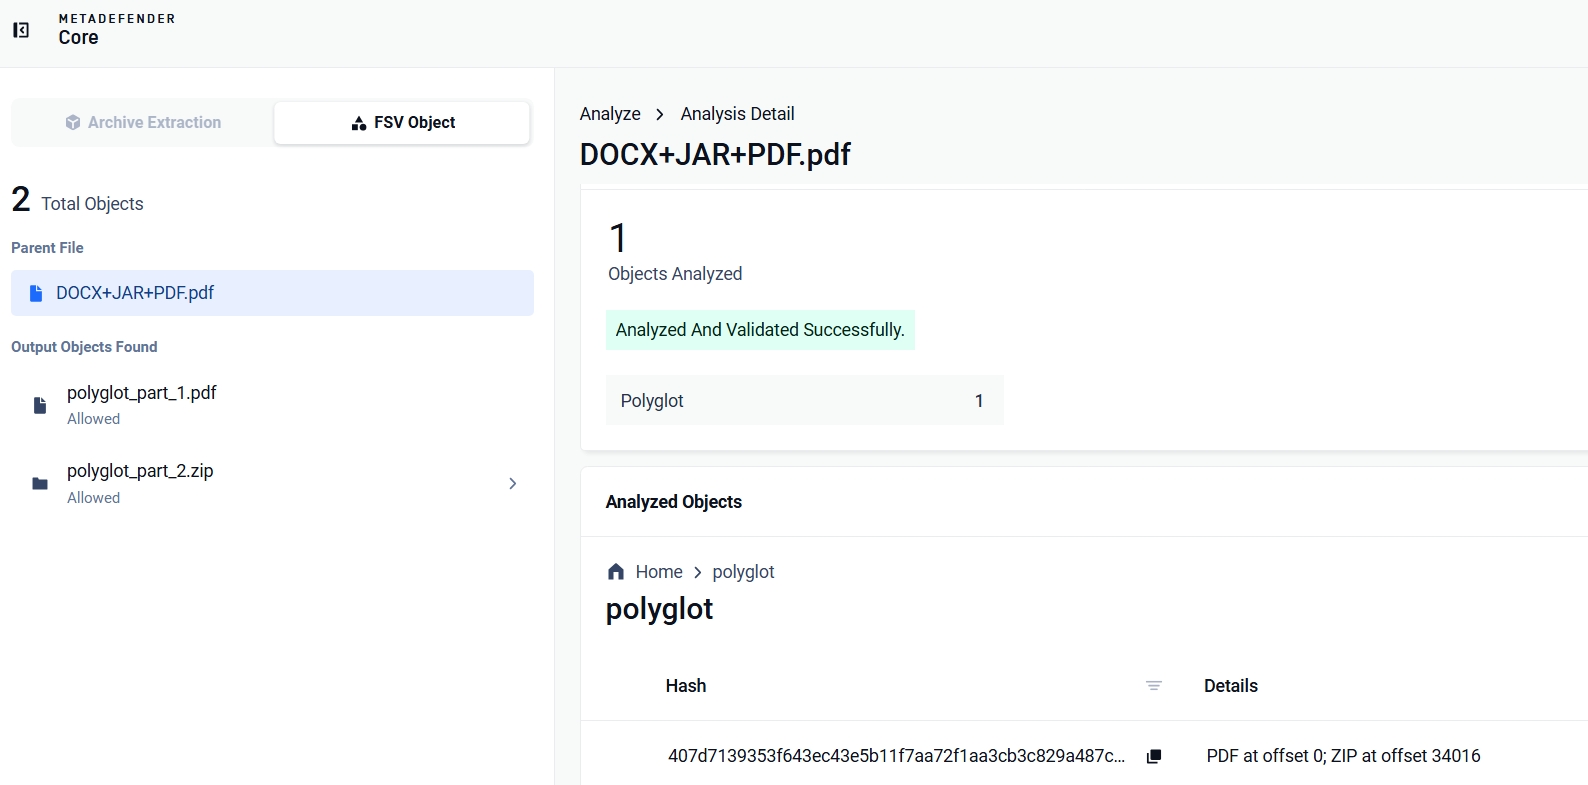
Le moteur a séparé un échantillon PDF contenant secrètement un document Word (un fichier « polyglotte » PDF+JAR+DOCX) en deux parties : la partie PDF et la partie ZIP. Les formats JAR et DOCX étant tous deux des conteneurs ZIP, une seule partie ZIP répond aux deux spécifications. Le moteur « File Type » a alors identifié cette partie comme étant un DOCX, et la technologie Deep CDR™ l’a nettoyée individuellement. La partie cachée subit ainsi le traitement même qu’elle était censée contourner.
La précision, c'est là que réside toute la difficulté
Les « magic bytes » apparaissent naturellement dans des fichiers inoffensifs ; l’effort technique réel consiste donc à ne pas crier au loup. Les photos prises avec un appareil photo intègrent des vignettes EXIF qui comportent leur propre signature JPEG. Les documents Office intègrent des images au sein de leur structure conteneur. Les fichiers « Media » contiennent aléatoirement des séquences d’octets qui ressemblent à des en-têtes de compression. La logique de détection exclut les octets déjà pris en compte par une structure légitime, et ce renforcement de la sécurité est continuellement étendu, format par format. Un détecteur qui signale chaque photo prise avec un appareil photo est désactivé, et un détecteur désactivé ne protège personne.
Testé auprès de véritables polyglottes
Nous avons testé de véritables échantillons polyglottes sur un déploiement en production d’ MetaDefender Core™, à l’aide du moteur de validation de la structure des fichiers. Tous ont été détectés, et chaque face a été localisée avec précision à son décalage d’octet exact :
Exemple | Faces détectées (décalage) | Résultats |
PDF contenant un document Word (PDF + JAR + DOCX dans un seul fichier) | PDF @ 0 · ZIP @ 34 016 | Extraction des visages ; nettoyage du fichier DOCX caché grâce à la technologie Deep CDR™ |
GIF dissimulant une archive et une deuxième image | GIF89a @ 0 · ZIP @ 25 214 · TIFF @ 154 270 | Détecté |
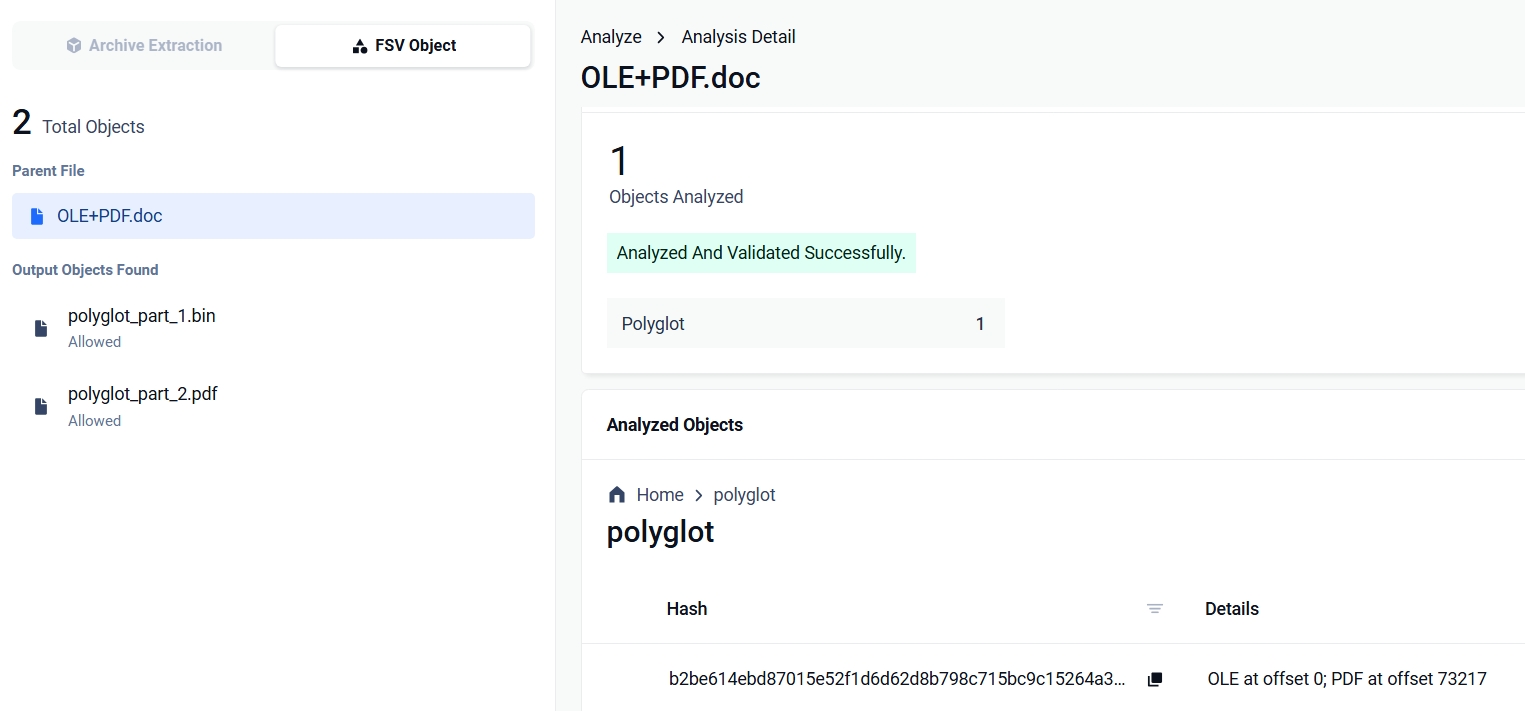
Document Office contenant un fichier PDF masqué | OLE @ 0 · PDF @ 73 217 | Détecté |
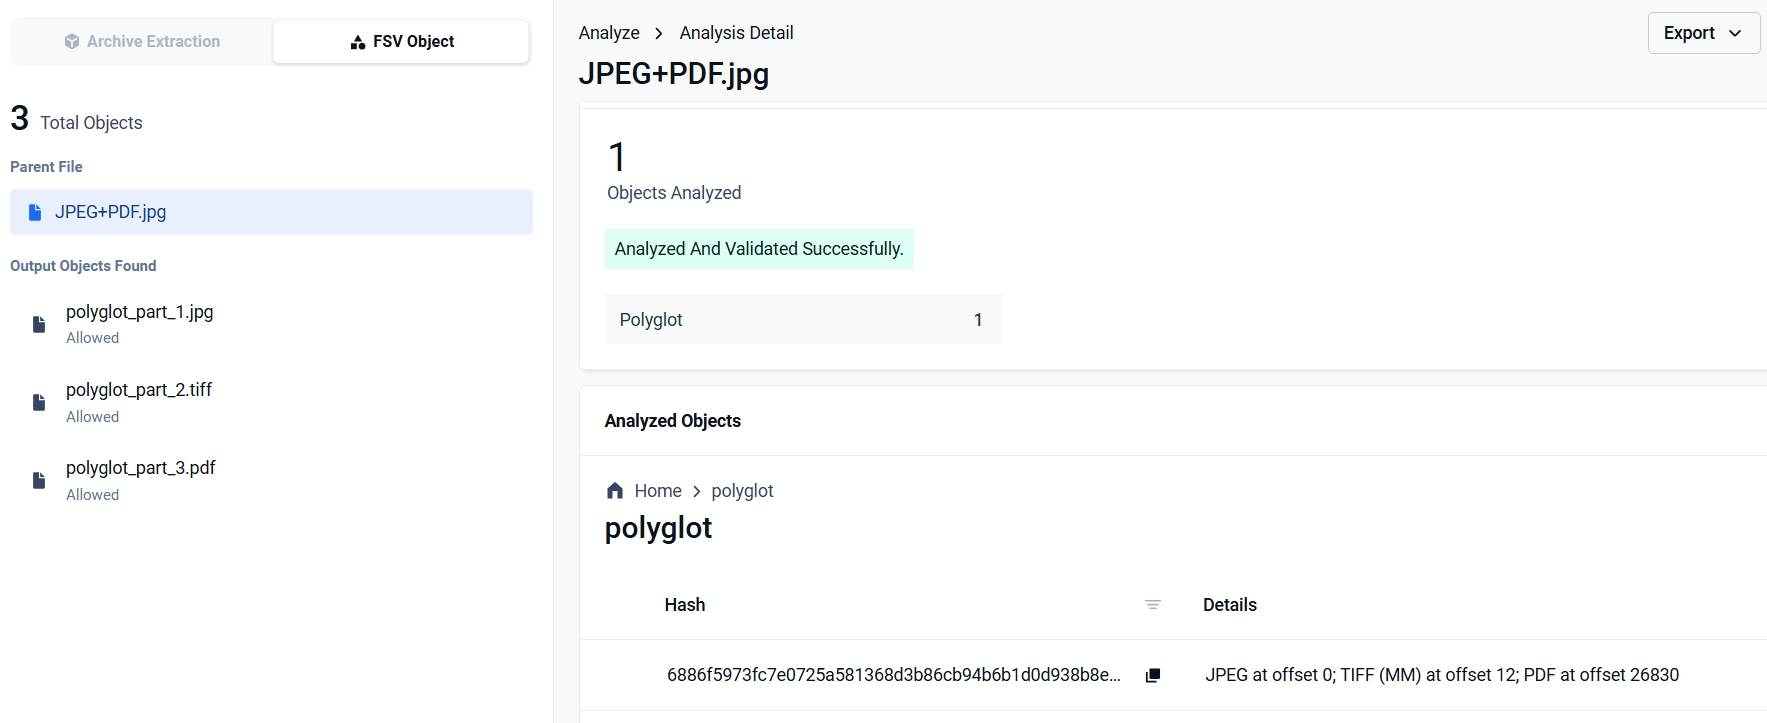
Un fichier JPEG contenant un PDF | Trois visages, fichier PDF joint @ 26 830 | Détecté |
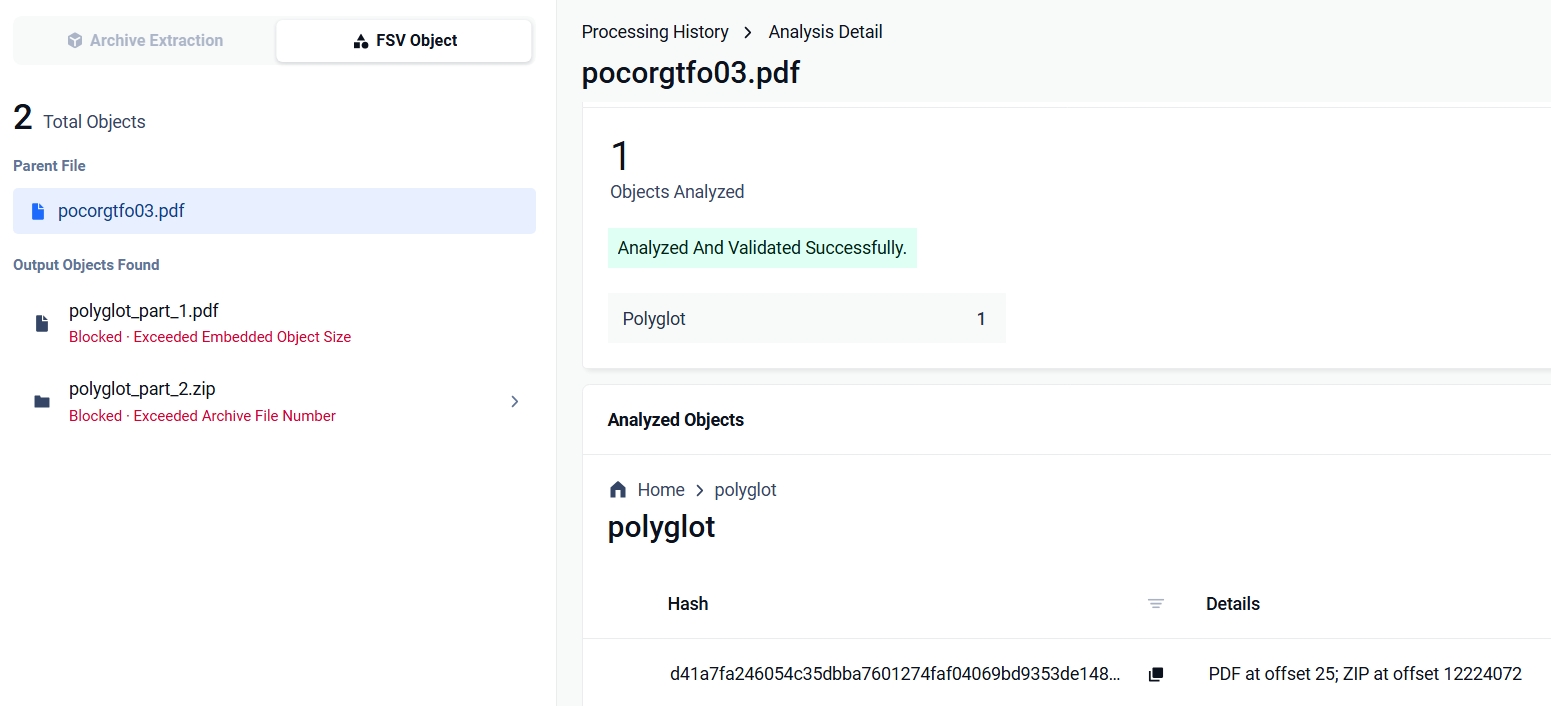
« PoC‖GTFO », numéro 3, le fanzine consacré à la recherche en sécurité, disponible au format PDF+ZIP en plusieurs langues, 26 Mo | PDF : 25 · ZIP : 12 224 072 | Détecté : le deuxième visage a été trouvé à 12 Mo de profondeur lors d'une analyse complète |
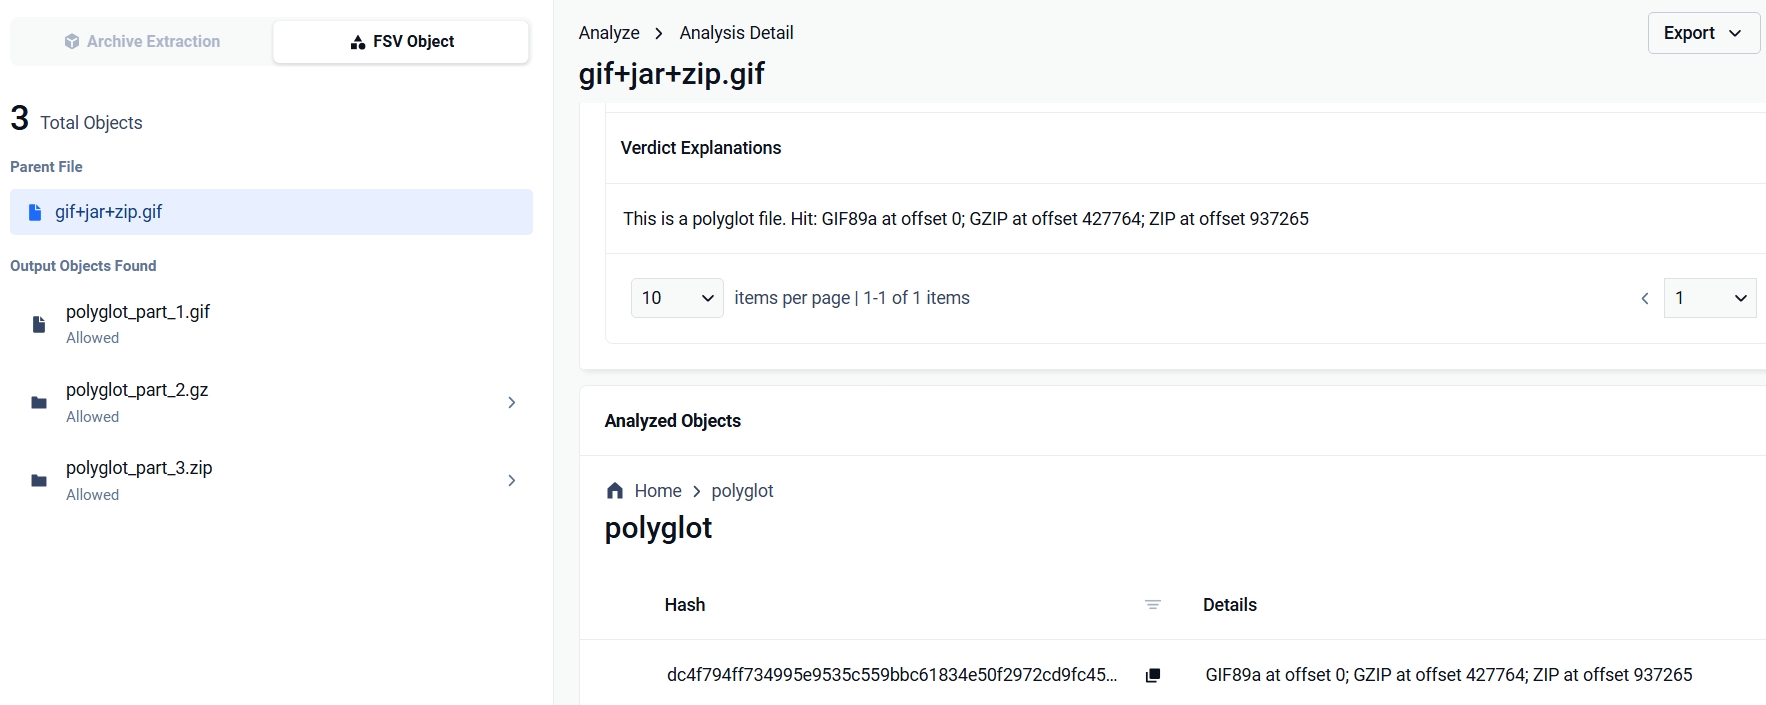
Fichier GIF contenant un flux GZIP et une archive Java | GIF89a @ 0 · GZIP @ 427 764 · ZIP @ 937 265 | Bloqué |
Fichier PDF contenant un fichier JPG et un fichier PNG, avec un fichier ZIP et un fichier TIFF joints | PDF : 0 · ZIP : 204 849 · TIFF : 257 395 | Bloqué ; les images intégrées ne s'affichent pas correctement |
La dernière ligne illustre le fonctionnement de la règle de rejet : le verdict identifie les fichiers ZIP et TIFF joints et ignore les images contenues dans le PDF. Le résolveur de conteneurs les a considérées comme faisant partie du contenu du PDF lui-même. Voici le JSON de résultat généré par MetaDefender Core™ pour ce fichier (version abrégée) :
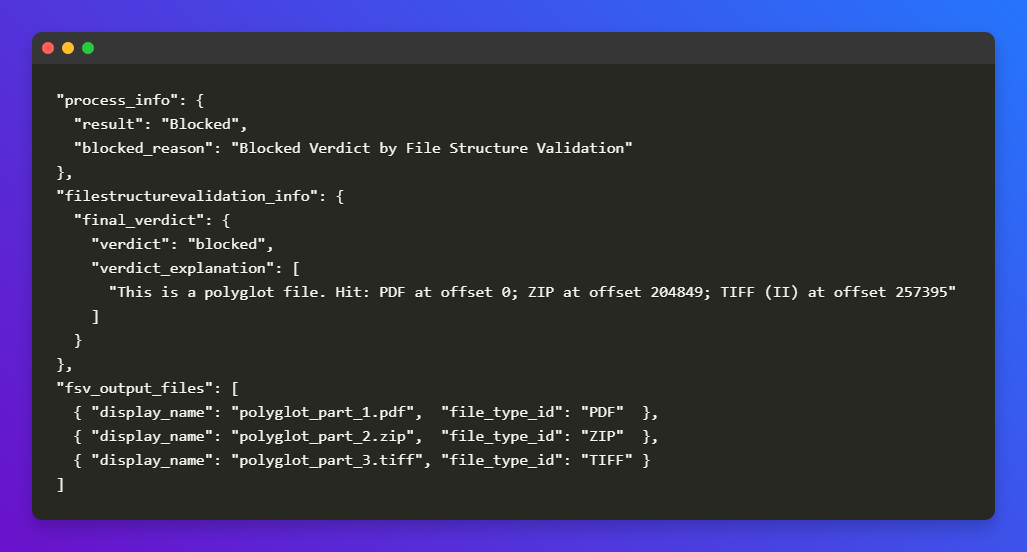
La liste « fsv_output_files » correspond à la dissection décrite ci-dessus, en temps réel : les trois faces ont été extraites et renvoyées vers le flux de travail en tant qu'objets distincts.
Voici les captures d'écran des différents exemples de résultats dans MetaDefender Core™ :
Couverture et configuration
La prise en charge actuelle couvre les formats que les pirates combinent réellement : PDF, ZIP, fichiers composites OLE, PNG, GIF, JPEG, TIFF, RAR, GZIP et 7z.
La résolution structurelle de fin de conteneur s'applique aux formats de conteneurs. Cette fonctionnalité est fournie selon une approche « configuration d'abord » : la détection, le blocage et l'analyse complète des fichiers sont autant de paramètres de stratégie, ce qui permet aux opérateurs de choisir entre la visibilité et l'application des règles pour chaque déploiement.
Le bilan
Un fichier comportant deux faces valides déjoue tout pipeline qui lui attribue un seul type, or la détection à type unique est le principe sur lequel reposent la plupart des piles d’analyse. La détection structurelle polyglotte comble cette lacune en identifiant toutes les faces et en vérifiant que chacune d’entre elles peut être analysée. La politique de sécurité peut alors bloquer le fichier avant qu’une application ne choisisse le mauvais interpréteur.
La détection des formats d'attaque courants est désormais prise en charge. La résolution de la fin du conteneur pour les formats d'archives restants est prévue dans la feuille de route.
Découvrez comment la validation de la structure des fichiers gère les formats de fichiers transitant par votre environnement.